Série “Un cluster Kubernetes avec GPU pour faire de l’inférence LLM”
- Déployer un cluster Kubernetes immuable avec Talos sur Proxmox (cet article)
- Passer un GPU NVIDIA dans un cluster Kubernetes (En cours d’écriture)
- Piloter un cluster Kubernetes en GitOps avec Flux (En cours d’écriture)
- Inférence LLM auto-hébergée sur Kubernetes (En cours d’écriture)
Introduction
Après avoir déployé un cluster Kubernetes sur Proxmox avec Kubespray, j’ai voulu régler un point qui me gênait : la maintenance de l’OS sous le cluster. Dans cet article, je reprends le sujet depuis zéro avec Talos Linux, une distribution immuable dédiée à Kubernetes, que je provisionne entièrement avec OpenTofu.
Cet article est le premier d’une série dont l’objectif final est de faire tourner de l’inférence LLM sur un GPU passé au cluster. Le cluster décrit ici en est la base, et il contient donc déjà un nœud prévu pour le GPU.
Contexte
Mon précédent article détaillait le déploiement d’un cluster Kubernetes avec Kubespray. Le résultat était reproductible, mais l’automatisation s’arrêtait à l’OS : les trois VMs Debian restaient des systèmes classiques, avec leurs mises à jour de paquets, leur accès SSH et une configuration qui pouvait dériver entre deux lancements du playbook.
Avec Talos, l’OS n’est plus administrable directement : il n’y a ni shell, ni SSH, ni gestionnaire de paquets. La seule interface est une API gRPC, et toute la machine est décrite par un fichier de configuration YAML appliqué de manière déclarative. Pour modifier un nœud, je modifie sa configuration et Talos l’applique.
Talos n’est pas meilleur que Kubespray dans l’absolu. Je perds la possibilité d’intervenir à la main sur un nœud, mais en échange je sais qu’aucun nœud n’a été modifié en dehors du code.
Composants
| Composant | Version | Rôle |
|---|---|---|
| Proxmox | 9.1 | Hyperviseur |
| Talos Linux | 1.13.8 | OS des nœuds |
| Kubernetes | v1.36.2 | Orchestrateur |
| OpenTofu | 1.11.5 | Création des VMs et configuration Talos |
Provider bpg/proxmox | 0.114.0 | Pilotage de Proxmox |
Provider siderolabs/talos | 0.12 | Pilotage de Talos |
| Composant GitLab CI OpenTofu | 4.5.0 | Pipeline de déploiement |
| Cilium | 1.20.2 | CNI, remplace kube-proxy |
J’ai choisi OpenTofu plutôt que Terraform pour rester cohérent avec ma ligne sur les logiciels open source et leurs licences. Depuis que HashiCorp a passé Terraform sous licence BUSL en 2023, OpenTofu est le fork qui reste sous licence MPL 2.0. Son évolution est aussi davantage guidée par les demandes de fonctionnalités de la communauté, alors que celle de Terraform s’oriente vers les offres Enterprise et Cloud de HashiCorp, qui ne m’intéressent pas.
Talos Linux
Talos est une distribution Linux qui ne contient que ce qu’il faut pour faire tourner Kubernetes : un noyau, son propre système d’init, containerd et les composants du cluster. Quelques-unes de ses propriétés expliquent la plupart des choix faits dans la suite de l’article :
- Le système de fichiers racine est en lecture seule, monté depuis une image squashfs. Les données qui doivent persister (etcd, images de conteneurs) sont écrites sous
/var, sur une partition dédiée. Il n’y a donc aucun endroit où déposer un binaire ou modifier un fichier de configuration à la main. - Les mises à jour suivent un schéma A/B. La nouvelle version est installée à côté de la version en cours, et si la mise à jour échoue, le nœud peut redémarrer sur l’ancienne.
- Il n’y a pas de systemd. Le kubelet, etcd, containerd et l’API Talos sont gérés par
machined, et leur configuration vient entièrement de la machine config. Il n’est pas possible d’ajouter un service ou d’en surcharger un. - L’administration passe uniquement par une API gRPC, exposée sur le port
50000de chaque nœud avec une authentification TLS mutuelle. Le fichiertalosconfigutilisé partalosctlcontient la CA du cluster et un certificat client, et sans ce fichier, un nœud Talos refuse toute connexion.
Toute la configuration d’un nœud tient donc dans un seul fichier YAML, la machine config, qui comporte deux grandes sections : machine.* pour le nœud lui-même (réseau, disques, kubelet, modules noyau) et cluster.* pour le cluster Kubernetes (CNI, kube-proxy, manifests additionnels).
Configuration machine et configuration cluster
Ces deux sections sont dans le même fichier, mais elles ne sont pas appliquées de la même manière :
machine.*est réconcilié en continu. Les contrôleurs de Talos surveillent la configuration et ajustent l’état du nœud. Un patch qui modifiemachine.networkoumachine.kubeletest appliqué immédiatement, parfois après le redémarrage du service concerné.cluster.*n’est lu qu’au bootstrap. Au moment dutalos_machine_bootstrap, Talos génère des manifests Kubernetes à partir de cette section et les applique au cluster. La section reste ensuite dans la configuration, mais elle n’est plus relue.
En pratique, modifier cluster.network.cni.name sur un cluster déjà démarré ne supprime pas le CNI en place, et Talos n’affiche aucune erreur ni aucun avertissement. Les manifests générés à partir de cluster.* ne sont rejoués, avec suppression de ceux qui ne sont plus générés, que pendant un talosctl upgrade-k8s.
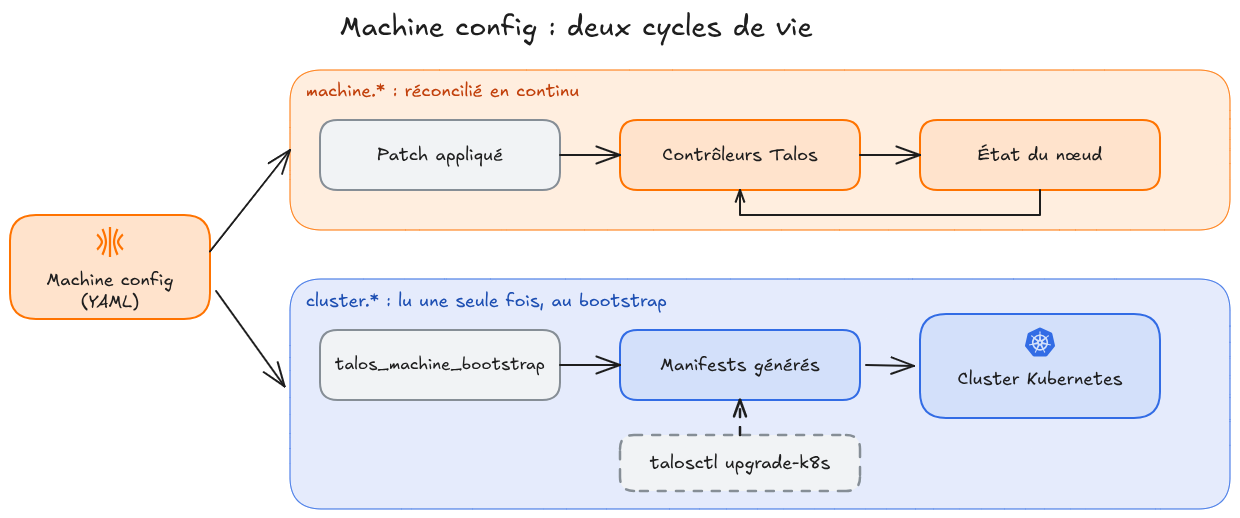
Les deux cycles de vie de la machine config
Architecture cible
| Rôle | Hostname | VM ID | IP | vCPU | RAM | Disque |
|---|---|---|---|---|---|---|
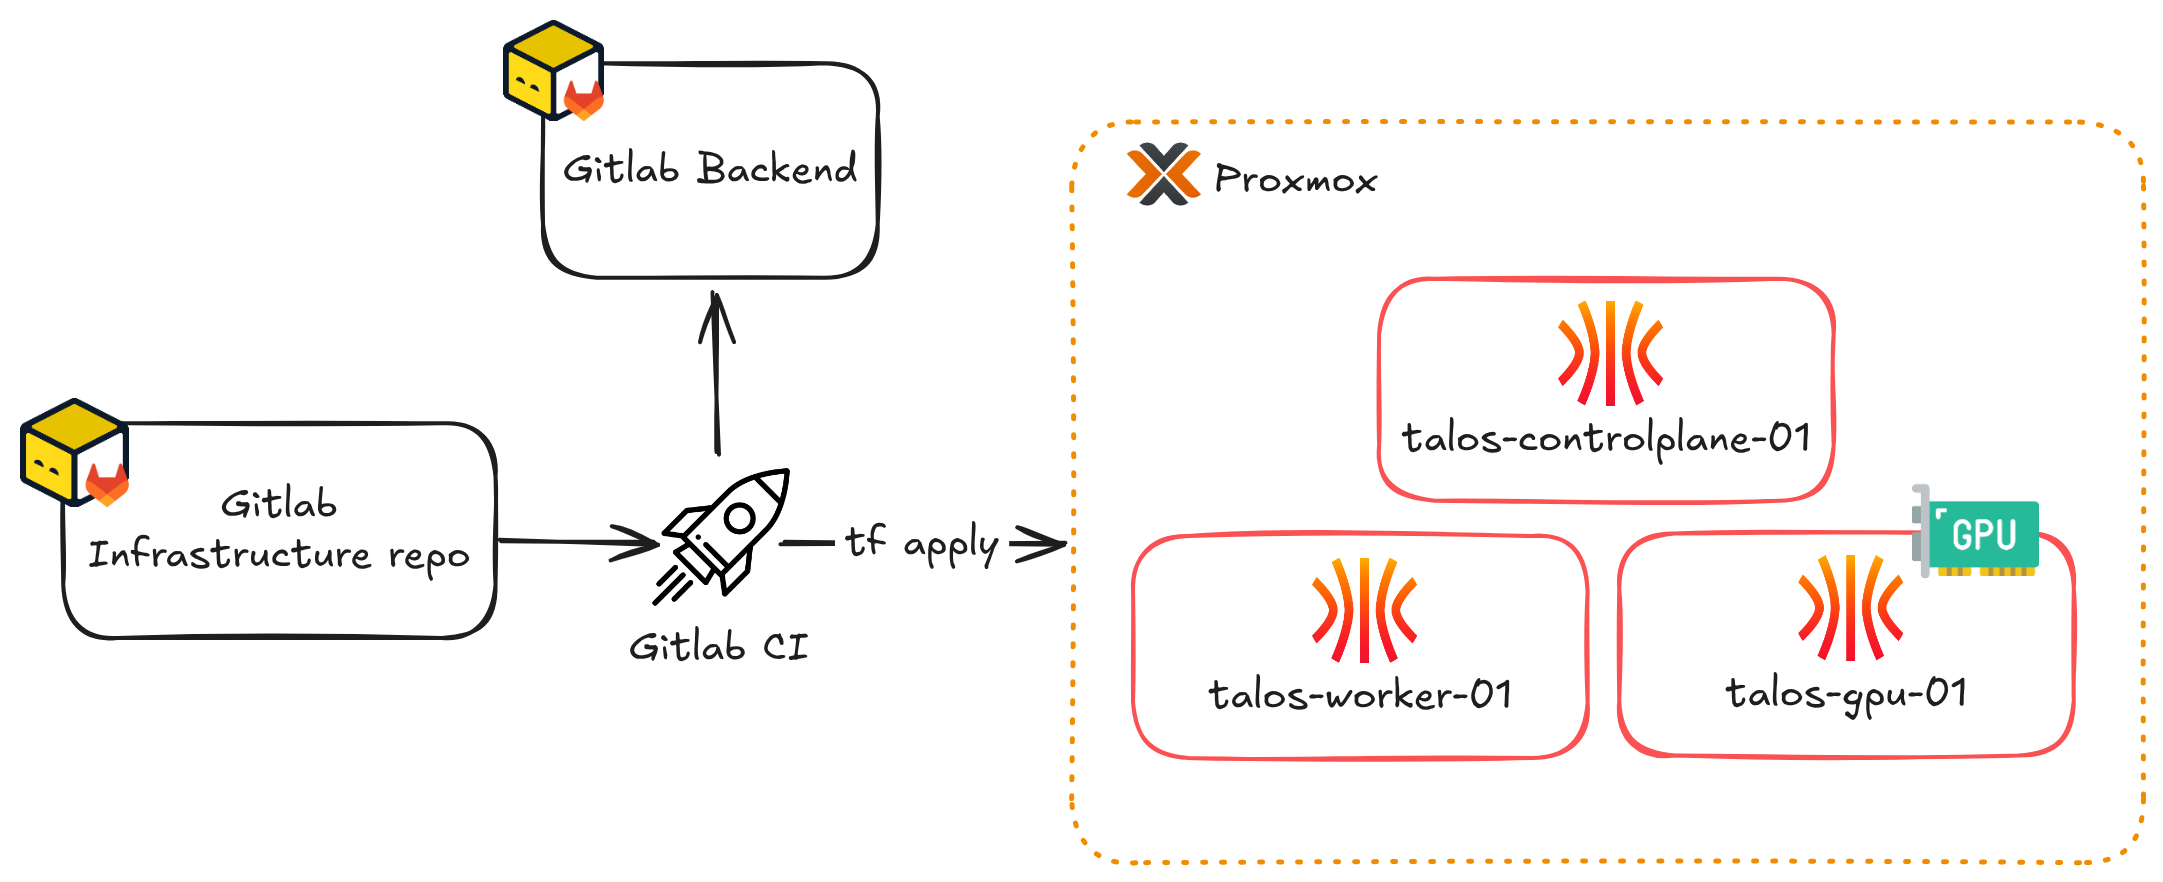
| Control plane | talos-controlplane-01 | 121 | 192.168.1.121 | 2 | 4 GB | 50 GB |
| Worker | talos-worker-01 | 122 | 192.168.1.122 | 4 | 8 GB | 100 GB |
| Worker GPU | talos-gpu-01 | 123 | 192.168.1.123 | 4 | 12 GB | 100 GB |
L’API Kubernetes ne répond pas sur l’IP d’un nœud mais sur une VIP, 192.168.1.120. Cette adresse est réservée, et les nœuds commencent donc à .121.
NoteIl n’y a qu’un seul control plane, comme dans mon article sur Kubespray, et pour la même raison : c’est un homelab. J’ai quand même configuré la VIP dès la création, car elle est inscrite dans la configuration de chaque nœud et la mettre en place plus tard obligerait à reconfigurer tout le cluster.
Un nœud GPU déclaré dès le départ
Le troisième nœud s’appelle talos-gpu-01, même si aucune carte graphique n’est utilisée dans cet article. Il se distingue déjà des deux autres sur trois points :
- 12 GB de RAM au lieu de 8. Le passthrough PCI impose de désactiver le ballooning, donc cette mémoire sera réservée en permanence sur l’hôte. J’ai préféré dimensionner le nœud tout de suite en conséquence.
- Une image Talos différente. Les modules NVIDIA sont fournis par des extensions système, qui sont intégrées à l’image au moment de sa construction. Ce nœud a donc sa propre image.
- Un patch de configuration qui ne concerne que lui. Charger les modules NVIDIA sur un nœud sans carte produit une erreur à chaque démarrage.
Ce dernier point a une conséquence sur la façon d’organiser la configuration : dès qu’un nœud est différent des autres, une configuration par rôle ne suffit plus. Je détaille la solution dans la partie sur les patches.
Provisionnement avec OpenTofu
Les images : Talos Image Factory
Une image Talos ne peut pas être modifiée après coup. Pour ajouter qemu-guest-agent ou les modules NVIDIA, il faut une image qui les contient déjà, et c’est le rôle de l’Image Factory : on lui envoie une liste d’extensions, et elle renvoie un schematic ID, un hash qui identifie cette liste. Ce hash permet ensuite de construire l’URL de l’image pour n’importe quelle version de Talos.
| Schematic | Extensions | Nœuds |
|---|---|---|
ce4c9805... | qemu-guest-agent | controlplane-01, worker-01 |
a31d81ec... | qemu-guest-agent, nvidia-open-gpu-kernel-modules, nvidia-container-toolkit | gpu-01 |
L’image téléchargée est un disque brut compressé, nocloud-amd64.raw.xz. Elle change deux choses par rapport à mes déploiements précédents :
nocloudest la plateforme cible. Avec elle, Talos lit sa configuration réseau initiale sur le lecteur cloud-init fourni par Proxmox, ce qui rend le nœud joignable dès le premier démarrage, avant qu’il ait reçu sa machine config.- Il n’y a plus de template. Mes VMs Debian sont clonées depuis un template construit avec Packer, alors que les nœuds Talos importent directement cette image comme disque
scsi0. Je n’ai donc plus de template à reconstruire pour ce cluster : pour changer de version de Talos, je modifie une variable.
Le téléchargement utilise un for_each sur les schematics réellement utilisés, ce qui évite de télécharger deux fois la même image quand plusieurs nœuds partagent le même schematic :
| |
L’image est téléchargée au format .raw.xz, alors que decompression_algorithm vaut zst. Le provider n’accepte que gz, lzo, zst et bz2, mais la décompression zst de Proxmox sait aussi traiter une archive xz. Ce comportement n’est pas documenté, je l’ai trouvé dans une discussion du provider bpg sur les images compressées en xz.
La topologie dans une variable
Toute la topologie du cluster est décrite dans une seule variable. Pour ajouter un nœud, il suffit d’ajouter un objet à cette liste :
| |
J’ai ajouté plus de validations que d’habitude sur cette variable, cinq au total :
roledoit valoircontrolplaneouworker- les hostnames doivent être uniques
- les IPs doivent être uniques
- il doit y avoir au moins un
controlplane - la VIP ne doit pas correspondre à l’IP d’un nœud
Sans ces validations, chacune de ces erreurs apparaîtrait au milieu d’un apply, sous la forme d’une erreur d’API Proxmox peu explicite, avec une partie de l’infrastructure déjà créée. Avec elles, l’erreur est détectée au plan, avant toute modification. Une sixième validation arrive dans la partie 2, pour vérifier que chaque hostpci.mapping correspond bien à un mapping déclaré.
Les VMs
Une seule ressource crée les trois nœuds :
| |
- Il n’y a pas de bloc
clone. Le disque système est l’image téléchargée plus haut, référencée par sonfile_id, et c’est ce qui remplace le template. machine = "q35"etbios = "ovmf"avec unefi_disk. Les VMs démarrent en UEFI, et le firmware OVMF a besoin d’un disque EFI pour stocker ses variables.- Le
vm_idest dérivé du dernier octet de l’IP.192.168.1.123donne la VM 123, ce qui me permet de faire directement le lien entre l’interface Proxmox et le réseau. floating = 0désactive le ballooning, ce qui est obligatoire pour le nœud GPU de la partie 2.
NoteLe lecteur cloud-init d’un nœud Talos ne sert pas à configurer Talos. Il donne seulement une IP statique au nœud au premier démarrage, pour qu’il soit joignable en mode maintenance. Toute la configuration est ensuite appliquée par l’API Talos, via le provider
siderolabs/talos.
Les VMs sont prêtes à démarrer, il reste maintenant à leur fournir leur configuration.
La configuration machine
Générer les secrets et la configuration de base
Le provider siderolabs/talos enchaîne six ressources, dans cet ordre :
| |
talos_machine_secrets génère tout le matériel cryptographique du cluster : les CA de Kubernetes, de Talos et d’etcd, ainsi que les tokens d’enrôlement des nœuds. Ces secrets ne sont écrits nulle part sur le disque, ils sont stockés dans le state OpenTofu et n’en sortent que par les outputs.
Le bootstrap et la récupération du kubeconfig n’ont pas de for_each, car ce sont des opérations qui concernent le cluster entier. Elles ciblent un seul control plane, le premier de la liste :
| |
La ressource talos_machine_configuration_apply reçoit son argument node depuis la variable talos_nodes, et pas depuis un attribut de la VM. OpenTofu ne voit donc aucune dépendance entre les deux, et peut essayer d’appliquer la configuration à une IP qui ne répond pas encore. J’ai donc ajouté un depends_on explicite sur les VMs :
| |
Les patches, en trois niveaux
Une liste de patches par rôle ne suffit plus dès qu’un seul nœud a du matériel spécifique. J’ai donc organisé les patches en trois niveaux, du plus général au plus spécifique :
| |
La liste des patches de chaque nœud est construite avec fileset :
| |
Ce fonctionnement repose sur trois propriétés de fileset :
- Les fichiers sont triés par ordre alphabétique, donc le préfixe numérique de chaque fichier fixe l’ordre de fusion. Pour une même clé, c’est le dernier patch qui l’emporte : le niveau nœud écrase le niveau rôle, qui écrase le niveau commun. Je laisse des trous dans la numérotation (10, 20, 30) pour pouvoir intercaler un patch plus tard.
- Un répertoire absent renvoie un ensemble vide, sans erreur. Les trois niveaux sont donc facultatifs, ce qui est pratique puisque Git ne versionne pas les répertoires vides.
- Ajouter un patch ne demande aucune modification du code. Il suffit de déposer un fichier dans le bon répertoire,
talos.tfreste inchangé.
C’est le nœud GPU qui m’a amené à créer le niveau nodes/ : un patch NVIDIA placé sous worker/ serait aussi appliqué à talos-worker-01, dont l’image ne contient pas les extensions, et ce nœud échouerait à charger les modules à chaque démarrage.
La VIP
Talos gère la VIP lui-même, sans keepalived ni load balancer externe. Les control planes choisissent le nœud qui porte la VIP par une élection dans etcd : un seul la détient à un instant donné, et elle bascule automatiquement sur un autre control plane si ce nœud disparaît.
| |
L’interface est redéclarée en entier, et pas seulement complétée avec une entrée vip. La machine config est prioritaire sur la configuration réseau fournie par la plateforme nocloud : un patch qui ne contiendrait que la VIP ferait disparaître l’adressage statique fourni par le lecteur cloud-init, et le nœud deviendrait injoignable.
cluster_endpoint pointe lui aussi sur la VIP, et pas sur l’IP d’un nœud. Cette valeur est inscrite dans la configuration de tous les nœuds et dans le kubeconfig : si elle désignait un nœud précis, la perte de ce nœud couperait l’accès à l’API, et l’ajout d’un control plane obligerait à reconfigurer tout le cluster pour changer l’endpoint.
CNI et kube-proxy désactivés
| |
Par défaut, Talos installe Flannel comme CNI et kube-proxy. Je les remplace tous les deux par Cilium, donc je les désactive.
J’ai choisi Cilium pour trois raisons : il remplace kube-proxy, il gère les L2 announcements, que j’utilise plus tard dans la série pour annoncer les IP des services LoadBalancer sur mon réseau local, et le tout repose sur eBPF, une technologie sur laquelle je veux m’appuyer pour les évolutions de mon homelab.
Ce choix a deux conséquences :
- les nœuds restent dans l’état
NotReadytant qu’aucun CNI n’est installé, ce qui est normal - sans kube-proxy, le CNI doit joindre l’API server directement, car la ClusterIP du service
kubernetes.defaultn’est pas encore routable au moment où il démarre. C’est le rôle de KubePrism, que je présente dans la partie sur Cilium.
Ce patch est placé sur les control planes car ces manifests sont générés au bootstrap, depuis un control plane. Comme tout ce qui est sous cluster.*, il n’a d’effet qu’à ce moment-là : appliqué à un cluster déjà démarré, il ne supprime rien.
Certificats serving du kubelet
Par défaut, le kubelet expose son endpoint :10250 avec un certificat auto-signé qu’aucune CA du cluster ne reconnaît. D’où l’option --kubelet-insecure-tls présente dans la plupart des installations de metrics-server : le client ne vérifie pas le certificat du serveur, donc n’importe quelle machine capable de s’intercaler sur le réseau peut se faire passer pour un kubelet.
La première partie de la solution se trouve côté nœud :
| |
Avec cette option, le kubelet ne génère plus de certificat auto-signé et envoie une CSR à l’API server, avec le signer kubernetes.io/kubelet-serving. Le problème est que Kubernetes n’approuve jamais automatiquement les CSR de ce signer. Le kube-controller-manager sait signer le certificat, mais aucun composant du cluster ne l’approuve : les CSR restent en Pending et le kubelet garde son certificat auto-signé. C’est un choix volontaire du projet Kubernetes, qui laisse cette décision à chaque environnement.
La seconde partie se trouve donc côté cluster :
| |
kubelet-serving-cert-approver est un contrôleur qui approuve ces CSR. Il ne fait que les approuver : la signature reste faite par le kube-controller-manager, avec la clé de la CA du cluster. Avant d’approuver une demande, il vérifie qu’elle correspond bien à celle d’un kubelet :
- l’organisation du sujet est
system:nodes - le CN commence par
system:node:et correspond exactement à l’utilisateur qui a soumis la CSR - les usages demandés sont ceux d’un certificat serveur
- la demande ne contient pas de SAN de type email ou URI
En revanche, il ne vérifie pas que les adresses IP demandées dans les SAN appartiennent réellement au nœud, puisque son ClusterRole ne lui donne aucun accès aux objets Node. Un nœud déjà enrôlé dans le cluster peut donc obtenir un certificat valide pour l’IP d’un autre nœud.
Le gain de sécurité reste réel, mais il est limité : avant, n’importe quelle machine sur le réseau pouvait se faire passer pour un kubelet, alors qu’il faut maintenant disposer de l’identité d’un nœud du cluster. Dans mon cas, metrics-server vérifie désormais les certificats des kubelets avec la CA du cluster, sans --kubelet-insecure-tls.
Ces deux manifests doivent rester déployés en permanence, car la rotation des certificats est continue et chaque renouvellement produit une nouvelle CSR à approuver. Les URLs sont fixées sur une version précise, pour qu’un re-apply ne récupère pas un contenu différent et pour que Renovate puisse suivre les mises à jour.
La configuration est complète, je peux passer au déploiement.
Déploiement
Je ne lance pas d’apply en local. Le déploiement passe par un pipeline GitLab CI qui utilise le composant OpenTofu de GitLab :
| |
Le template validate-plan-apply ajoute quatre jobs : fmt et validate dans le stage validate, plan dans build, puis apply dans deploy. Par défaut, apply n’existe que sur la branche principale et doit être lancé à la main : une merge request s’arrête donc au plan, et rien n’est appliqué tant que je n’ai pas déclenché le job.
Le reste de la configuration tient en cinq points :
- Les jobs tournent sur mon propre runner, grâce au tag
homelab: un runner GitLab avec l’executor Docker, hébergé sur mon Proxmox. Il est sur le même réseau que l’API Proxmox, que les runners partagés de GitLab ne pourraient pas joindre. - Le state est géré par GitLab. Le bloc
backend "http" {}deproviders.tfest vide, et c’est le composant qui renseigne l’adresse du state du projet et les identifiants du job au moment de l’exécution. - Les secrets restent dans GitLab. Le token de l’API Proxmox et la clé SSH sont des variables CI/CD, transmises à OpenTofu par les variables
TF_VAR_*. - Le pipeline ne se déclenche que si
tofu/change, grâce à la règleworkflow. - Les versions sont suivies par Renovate, grâce aux commentaires
# renovate:placés au-dessus du composant.
Récupérer les accès
Les accès au cluster ne sont écrits nulle part sur le disque, ils sont dans le state, et il faut donc les extraire avec les outputs. Comme le state est stocké dans GitLab, je fais un tofu init local une seule fois, uniquement pour cette étape. GitLab fournit la commande d’init complète dans Operate > Terraform states, avec l’action Copy Terraform init command. Je récupère ensuite les deux fichiers :
| |
Le talosconfig généré par data.talos_client_configuration contient deux listes : les endpoints, auxquels talosctl se connecte réellement et qui ne contiennent que des control planes, et les nodes, qui sont les cibles par défaut des commandes et qui sont jointes en passant par un endpoint. C’est ce qui permet d’interroger un worker sans s’y connecter directement.
Par exemple, pour lister les services de talos-worker-01 :
| |
talosctl ouvre la connexion vers le control plane 192.168.1.121, qui relaie la requête jusqu’au worker 192.168.1.122. Sans -e, ce sont les endpoints du talosconfig qui sont utilisés, et -n suffit pour changer de cible.
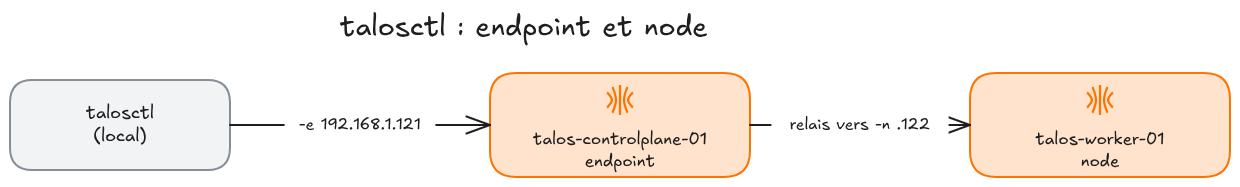
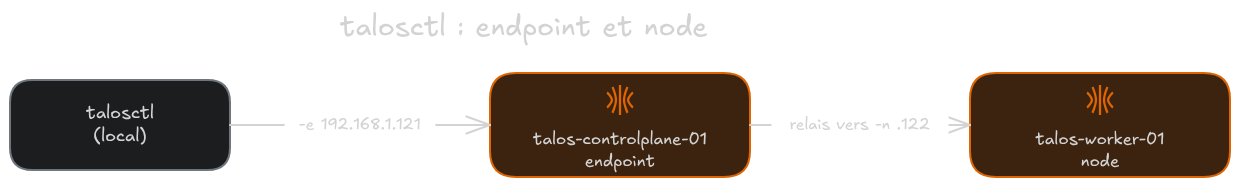
Endpoint et node avec talosctl
Installer Cilium
Le cluster démarre sans CNI, les nœuds sont donc NotReady. J’installe Cilium avec Helm, en remplacement de kube-proxy :
| |
| |
Les valeurs cgroup et securityContext sont spécifiques à Talos. Par défaut, le chart monte lui-même le cgroup2 et lance l’agent en mode privilégié, ce que Talos ne permet pas. J’ai repris la liste de capabilities de la documentation Talos pour Cilium plutôt que de la reconstruire.
Il reste le couple k8sServiceHost / k8sServicePort. On pourrait pointer Cilium sur la VIP en 6443, puisque c’est l’endpoint du cluster, mais ce n’est pas ce que recommande Talos. Cilium doit joindre l’API server avant que le réseau des pods existe, et la VIP dépend de l’élection etcd entre les control planes.
KubePrism répond à ce problème : c’est un load balancer local présent sur chaque nœud, qui écoute sur localhost:7445. Il choisit automatiquement parmi les endpoints disponibles (l’endpoint du cluster et chaque control plane), en écartant ceux qui ne répondent pas et en privilégiant les plus rapides. Il est activé par défaut, et la documentation Talos recommande de le donner comme endpoint aux CNI qui ont besoin de joindre l’API server, comme Cilium.
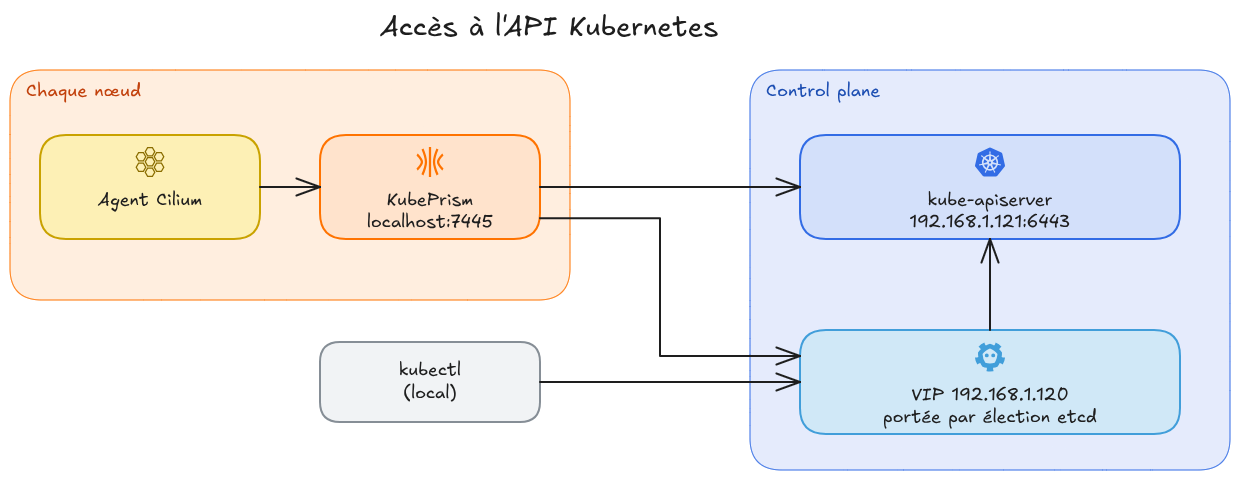
Accès à l'API Kubernetes
Vérification
Une fois Cilium installé, je vérifie l’état du cluster côté Talos avec talosctl health. J’ai retiré de la sortie les lignes de progression, pour ne garder que le résultat de chaque vérification :
| |
| |
La première adresse listée est la VIP et non 192.168.1.121 : le control plane qui la détient l’annonce parmi ses adresses, et elle est triée en premier.
Les trois SKIP viennent des choix faits dans les patches. talosctl health ne vérifie pas l’état Ready des nœuds ni CoreDNS quand le CNI est déclaré à none, puisque ces vérifications dépendent d’un CNI que Talos n’a pas installé lui-même, et il ignore kube-proxy quand son DaemonSet n’existe pas. L’état des nœuds se vérifie donc côté Kubernetes :
| |
| |
Les trois nœuds sont Ready, ce qui confirme que Cilium fonctionne sur chacun d’eux.
Pièges rencontrés
La courbe d’apprentissage de Talos
La prise en main de Talos m’a demandé du temps. Sans shell ni SSH, aucun de mes réflexes habituels pour diagnostiquer un nœud ne s’applique, et il faut passer par talosctl pour tout ce qui se faisait avant directement sur la machine. Il faut donc apprendre une nouvelle CLI, de nouveaux concepts et un nouveau nommage.
Un premier déploiement sans le provider Talos
Mon premier déploiement n’utilisait pas le provider siderolabs/talos : OpenTofu créait les VMs, et je générais puis appliquais les configurations à la main avec talosctl. Le passage au provider a ramené toute la configuration des nœuds as code, avec le reste de l’infrastructure, et permet donc d’avoir un déploiement de bout en bout en un seul run OpenTofu.
Un seul schematic pour tous les nœuds
Au départ, tous les nœuds utilisaient le même schematic, celui qui contient les extensions NVIDIA. Les nœuds sans GPU remontaient alors des erreurs liées aux pilotes NVIDIA, puisqu’ils embarquaient des modules prévus pour une carte qu’ils n’ont pas. C’est ce qui m’a amené à associer à chaque nœud un schematic qui ne contient que les extensions dont il a besoin.
Conclusion
Le cluster est opérationnel, et par rapport à Kubespray, je n’ai plus d’OS à administrer : pas de mises à jour de paquets, pas de SSH ouvert, et la configuration des nœuds ne peut pas s’écarter de ce que décrit le code. Une mise à jour de Talos se résume à changer une version dans une variable, et chaque nœud bascule sur la nouvelle image.
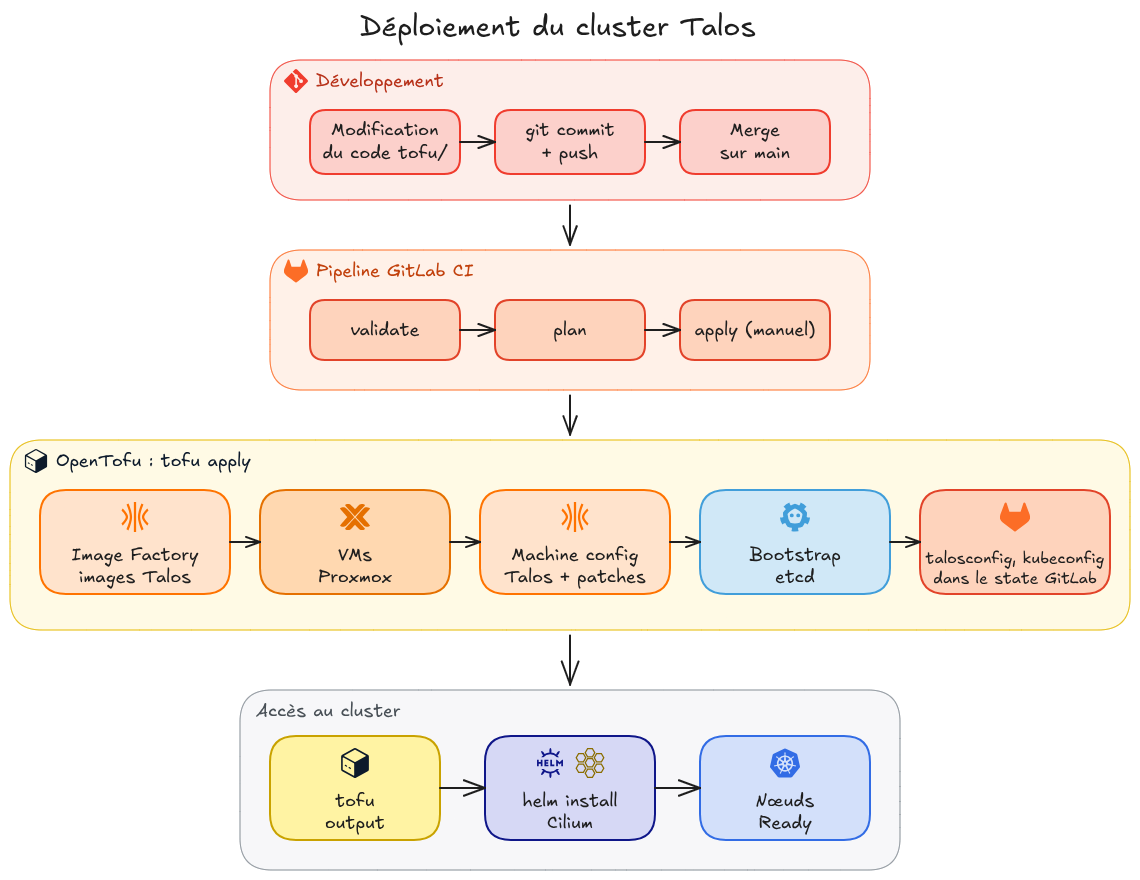
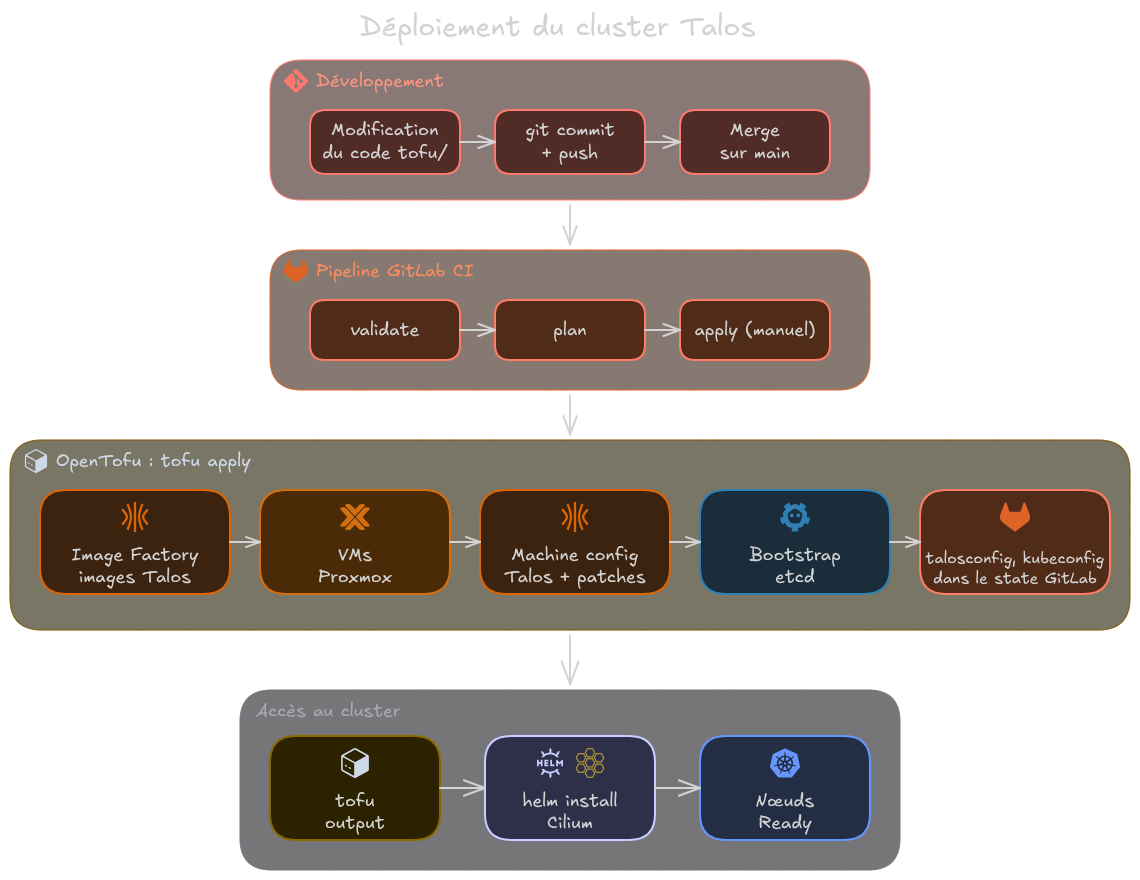
Résumé du workflow de déploiement
Une fois tout en place, j’ai surtout été surpris par la facilité et la rapidité avec lesquelles un cluster Kubernetes se monte. Là où Kubespray enchaînait près de 600 tâches Ansible, un seul run du pipeline crée les VMs, applique les configurations et bootstrappe le cluster, et il ne reste plus qu’à installer Cilium.
Le nœud talos-gpu-01 tourne déjà, avec ses 12 GB de RAM réservés et son image qui contient les modules NVIDIA, mais il ne voit encore aucune carte graphique. Faire passer le GPU de l’hôte Proxmox jusqu’aux pods est le sujet de la partie 2.